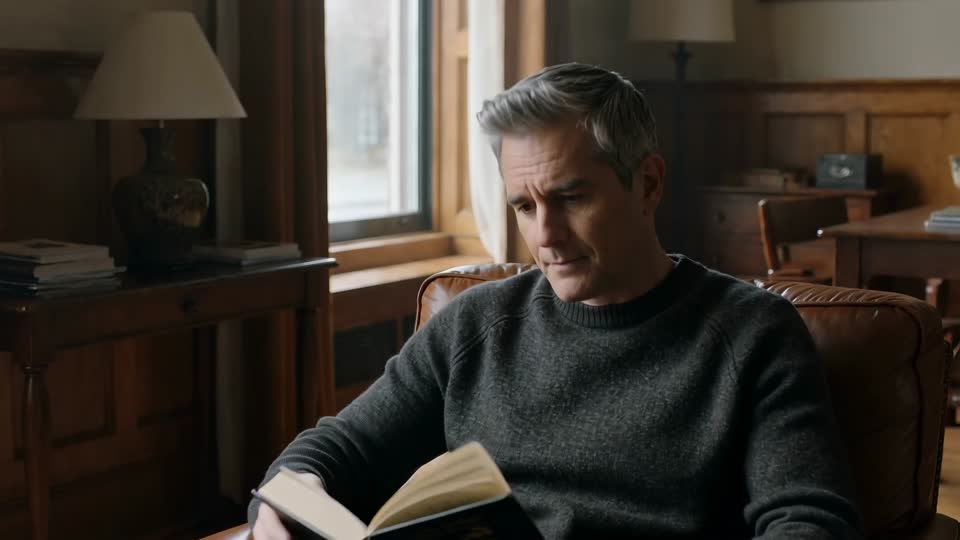
用不同景别讲述一个短场景
先用全景交代房间,再靠近阅读的人物,最后将视线移到书本。通过这条 HappyHorse 1.0 发布样例,观察切镜、镜头距离和柔和的窗边光线。
平台发布演示 · fal.ai · 1080p
fal.ai 发布的 1080p 样例,原始提示词可在来源页查看。
查看原始来源用 HappyHorse 1.0 从文字或图片创作视频,支持生成音频。
用 HappyHorse 1.0 编排短场景,写清光线、机位和动作顺序。也可以从照片开始确定起始构图,让画面与声音一起生成。
HappyHorse 1.0 支持3–15秒视频、720p/1080p、5 种宽高比;生成音频支持;尾帧不可用。
看看每条样例如何运用构图、运动或声音,再用自己的素材尝试提示词。
先用全景交代房间,再靠近阅读的人物,最后将视线移到书本。通过这条 HappyHorse 1.0 发布样例,观察切镜、镜头距离和柔和的窗边光线。
平台发布演示 · fal.ai · 1080p
fal.ai 发布的 1080p 样例,原始提示词可在来源页查看。
查看原始来源描述主体、光线和运镜,无需先准备照片即可探索新镜头。也可以用相同提示词比较不同模型的结果。
A plain cobalt blue ceramic cup rests on a pale wooden table beside a window. Soft morning light, gentle steam rising, one slow camera push-in. No people, no lettering, no logos. Keep the cup shape and tabletop stable.
AIVG 测试样例 · 5.041667s · 2026-09-06 · 当前报价: 170 积分
720p · 5s · 16:9
输入: 仅文字输入;包含生成音频。
检查要点: 镜头推进后,杯子在结尾出现裁切。需要检查整个视频的构图。
上传照片确定起始主体和构图,再描述需要的运动。将首帧及后续画面与原图对比,判断是否保留了重要细节。
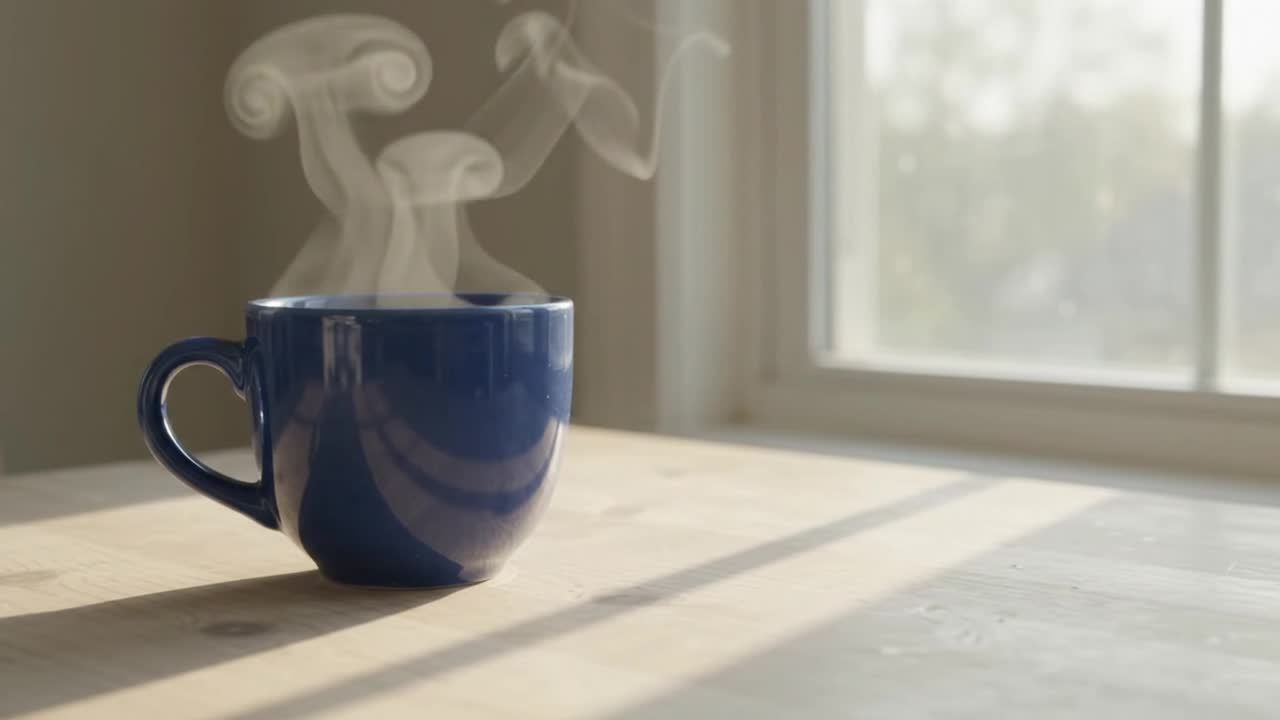
A plain cobalt blue ceramic cup rests on a pale wooden table beside a window. Soft morning light, gentle steam rising, one slow camera push-in. No people, no lettering, no logos. Keep the cup shape and tabletop stable.
AIVG 测试样例 · 5.041667s · 2026-09-06 · 当前报价: 170 积分
720p · 5s · 16:9
输入: 自己拥有或获准使用的照片;包含生成音频。
检查要点: 将杯把、蒸汽、构图和背景与起始图片对比。起始帧并不保证后续所有画面都完整保留细节。
使用步骤
创作新场景可从文字开始;想确定起始画面,则上传清晰照片。
写清主体、一个动作和一次运镜。样例使用蓝色杯子与缓慢推进。
确认准确积分后生成,在创作页面播放完整结果;可以复用输入再做一个版本。
能力
配置示例 720p / 5s:170 积分,按 100 积分 / $1.99 USD 的积分包折合 $3.383 USD。需购买积分包;生成前以当前设置的准确报价为准。
AIVG 不提供 API、无限积分或去水印服务;官方账号事务请前往 Alibaba。
相关模型
| 模型 | 基线积分 | 最高分辨率 | 最长时长 | 原生音频 | 模式 |
|---|---|---|---|---|---|
| HappyHorse 1.0 | 170 积分 · 720p / 5s | 1080p | 15秒 | 支持 | 文生视频 / 图生视频 |
| Seedance 2.0 | 180 积分 · 480p · 21:9 · audio off / 5s | 720p | 15秒 | 支持 | 文生视频 / 图生视频 |
| Vidu Q3 Pro | 185 积分 · 720p · audio off / 5s | 1080p | 16秒 | 支持 | 文生视频 / 图生视频 |
| Runway Gen-4 Turbo | 150 积分 · model output / 5s | 由模型决定 | 10秒 | 不可用 | 图生视频 |
商业使用遵循各模型自己的条款——发布前请确认。
水印与导出权限取决于你的套餐和所选模型。
生成任务进入失败状态后,该任务扣除的积分会退回余额。
每次生成前给出精确报价。
用文字创作新视频,或让起始照片产生运动。在设置中选择时长、清晰度和可用的声音选项。
5 秒 720p 示例消耗 170 积分。其他设置价格不同,请在生成前查看本次金额。
本配置从文字或照片生成新视频。若需要修改某条已有视频,请进入 AI 视频编辑,选择 Gemini Omni 等支持该操作的模型。
每条样例都附有来源和设置,方便比较输入与结果;你自己的生成效果可能不同。
相关模型
每次生成前给出精确报价。